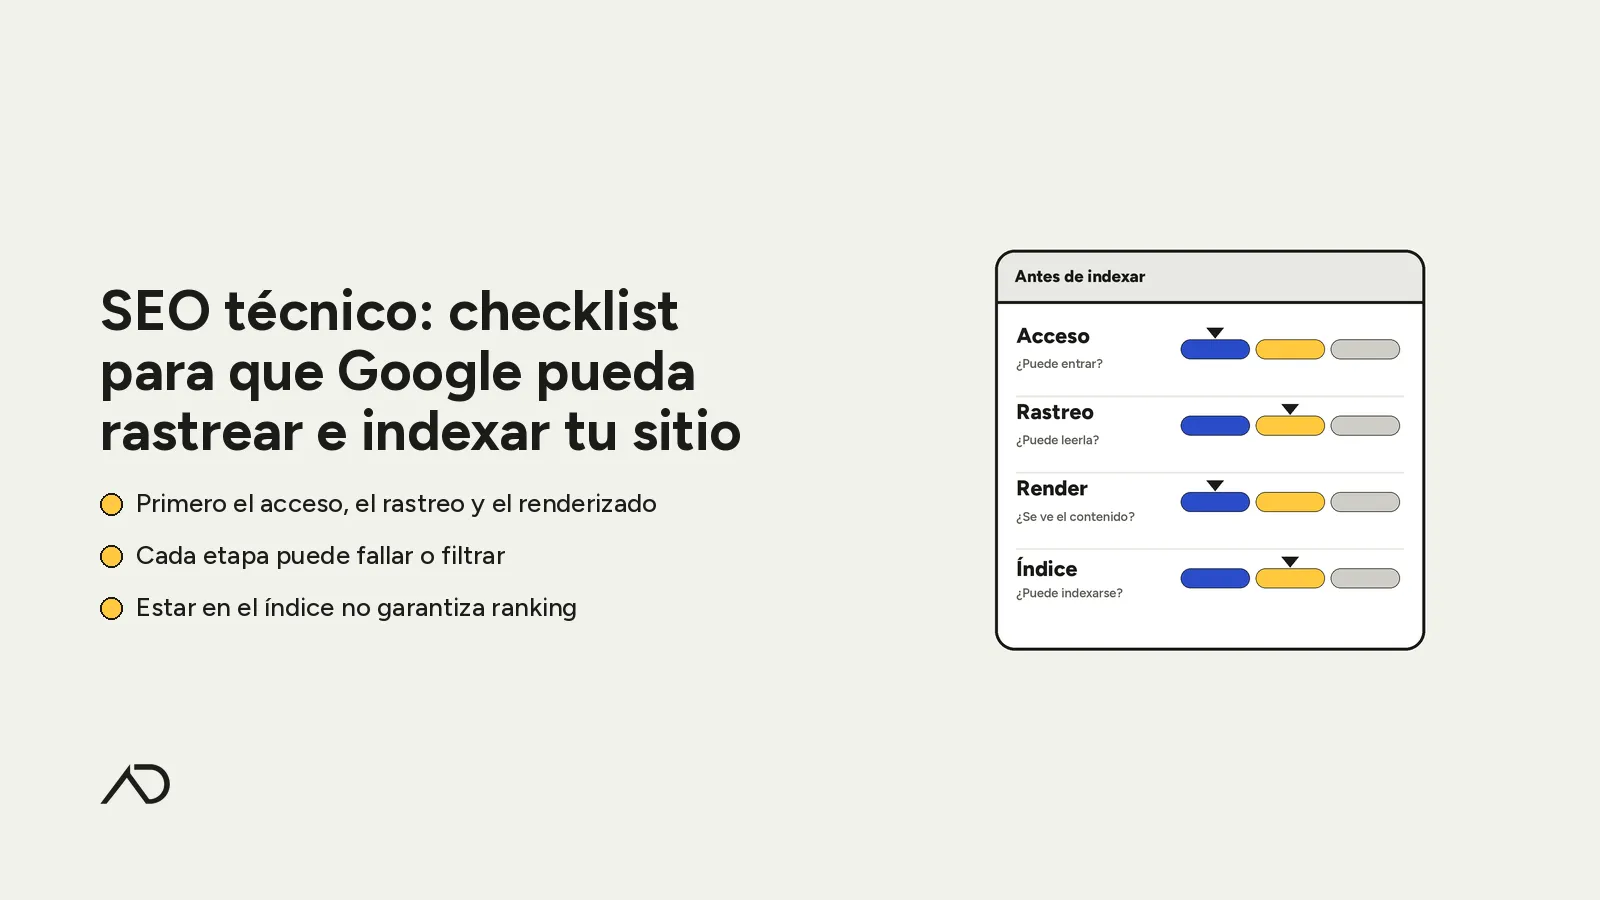
El SEO técnico es el trabajo que hace que Google pueda encontrar, rastrear e indexar las páginas de tu sitio. Es anterior a pelear una posición: si el rastreador no entra o la URL no se puede indexar, el resto de la optimización no tiene dónde apoyarse.
Rastrear, indexar y posicionar son tres cosas distintas. Esta nota es un checklist a nivel sitio para revisar acceso, indexabilidad, arquitectura, duplicados y lo que Googlebot necesita ver. No reemplaza una auditoría completa ni el trabajo de contenido de una URL puntual.
Rastreo, indexación y posicionamiento: tres cosas distintas
Que Google visite una URL no significa que la haya metido en el índice, y que esté en el índice no significa que vaya a aparecer arriba para la búsqueda que te importa.
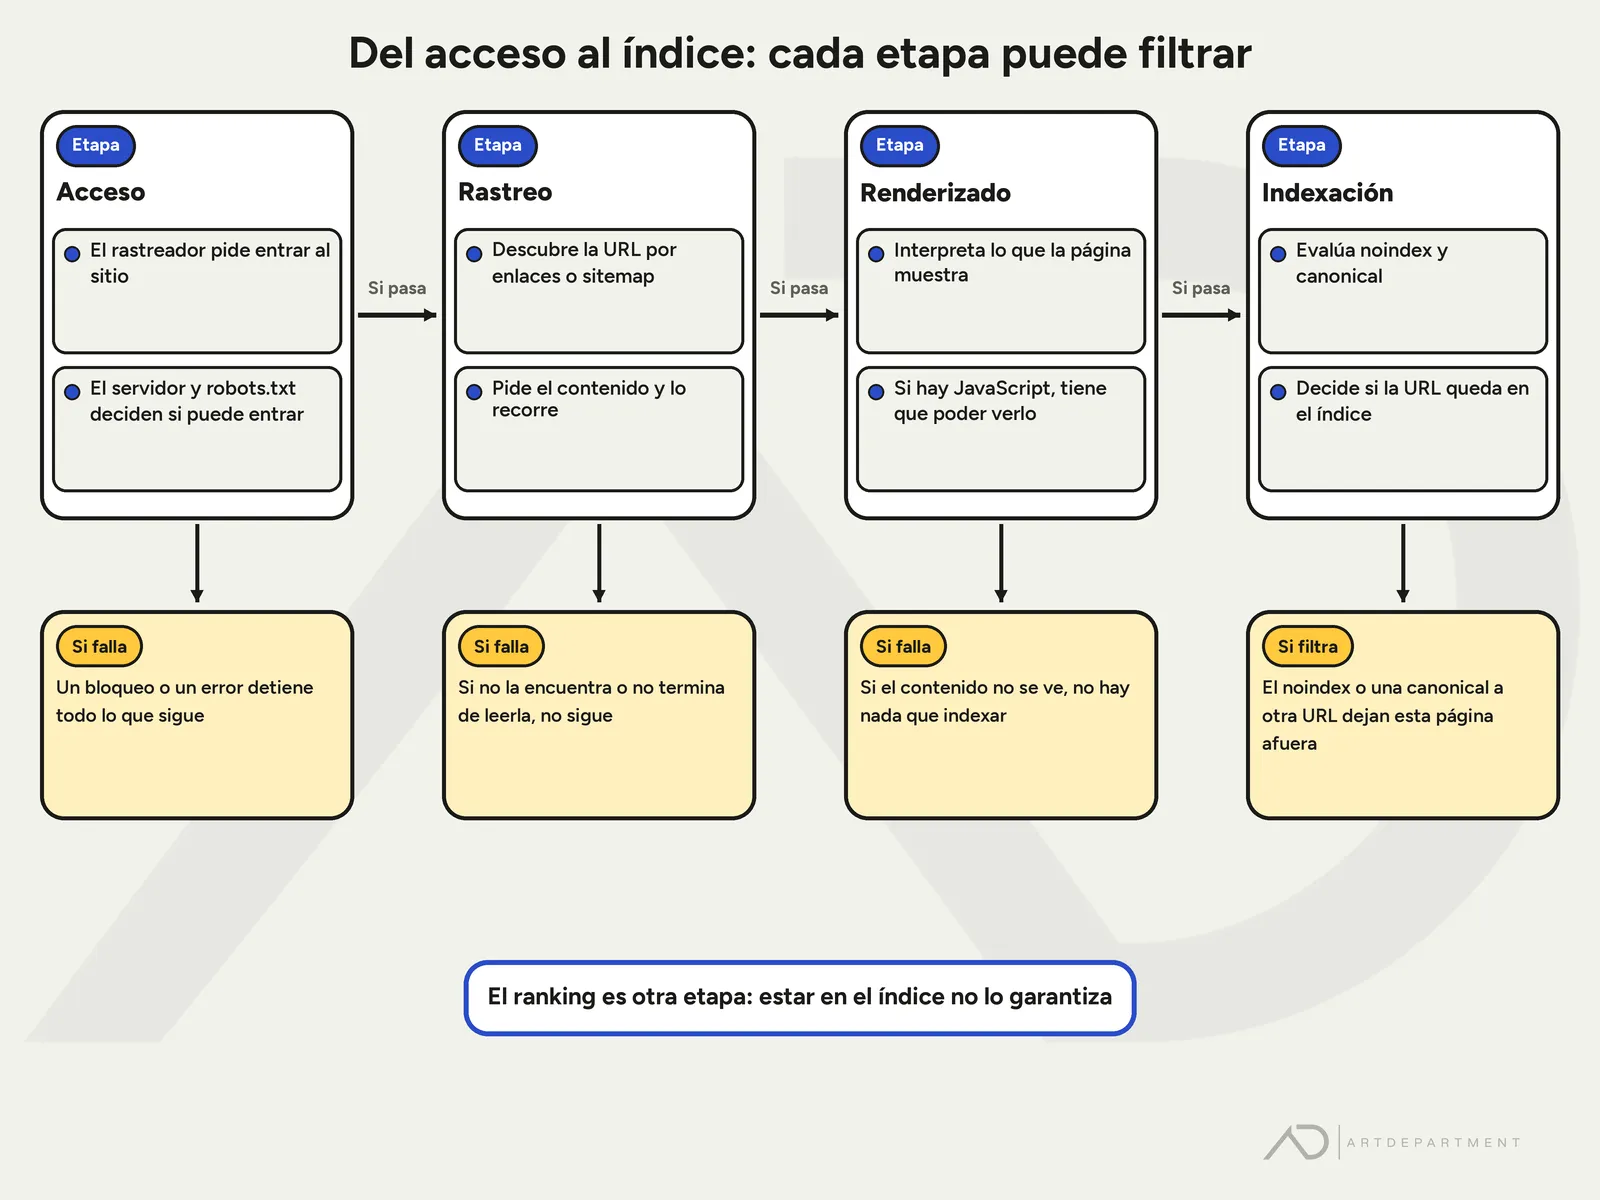
El rastreo es la visita: Googlebot pide la URL y lee lo que el servidor devuelve. La indexación es el paso siguiente: Google analiza esa página y decide si la guarda en su índice. El posicionamiento, o ranking, es la elección, entre muchas páginas ya indexadas, de cuáles mostrar y en qué orden.
Google documenta el rastreo y la indexación como un problema propio, separado de aparecer en los resultados. El circuito completo, con contenido y autoridad, está en qué es el SEO y cómo funciona el rastreo, el índice y el ranking. Una vez que la URL se puede rastrear e indexar, cómo posicionar una página concreta en Google es otra capa: título, contenido e intención.
Por eso una página puede estar rastreada y no indexada (Google la vio y eligió no guardarla, o todavía no la procesó) y otra puede estar indexada y no posicionar. El SEO técnico se ocupa de que eso no falle por un bloqueo, un error o una señal contradictoria.
Acceso de Googlebot: HTTP, robots.txt y código de respuesta
Googlebot solo puede trabajar con las URLs que logra pedir. Si el servidor responde con un error, si un login las esconde o si robots.txt le prohíbe el acceso, el rastreador no ve el contenido como lo ves vos.
El archivo robots.txt le indica a los rastreadores qué URLs pueden solicitar. Sirve sobre todo para no gastar pedidos en lo que no importa o para aliviar al servidor. No es un mecanismo para sacar una página de Google: una URL bloqueada puede aparecer igual en los resultados, a veces sin descripción, si otros sitios enlazan a ella.
200, redirecciones, 404 y errores del servidor
El código de respuesta le dice a Google qué hacer con esa petición. En Cómo afectan los códigos de estado HTTP a los rastreadores de Google está el detalle. En corto:
- Una respuesta exitosa (2xx) permite que el contenido se tenga en cuenta para indexar. Eso no garantiza la indexación.
- Una redirección lleva al rastreador a otra URL. Una redirección permanente es una señal fuerte de que el destino es el que hay que usar.
- Un 404 o un 410 le dicen que esa URL no existe: no se indexa, y si ya estaba en el índice se termina retirando.
- Un error del servidor (5xx) le pide al rastreador que afloje. Las URLs que ya estaban indexadas se pueden conservar un tiempo, pero si el error se mantiene acaban saliendo del índice.
No bloquees lo que querés indexar
Antes de publicar una página que te importa, comprobá que robots.txt no la esté bloqueando y que no pida usuario y contraseña al rastreador. Tampoco bloquees los archivos de estilo o de JavaScript que la página necesita para verse bien: si Google no puede cargarlos, puede entender mal el contenido.
Si una URL no debería existir, devolvé un 404 o un 410 de verdad. Una página de "no encontrado" que responde 200 confunde al rastreador y a la persona.
Indexabilidad: noindex, canonical y por qué robots.txt no desindexa
Para que una URL no entre al índice, o salga de él, usá noindex o protegé la página con un login. No uses robots.txt como reemplazo.
Google lo explica al hablar de impedir que la Búsqueda indexe páginas con noindex: la regla noindex (en una etiqueta meta o en el encabezado HTTP) solo funciona si el rastreador puede acceder a la página y leerla. Si robots.txt bloquea esa URL, Google no ve el noindex y la dirección puede seguir apareciendo en los resultados. Google no admite poner noindex dentro de robots.txt.
La etiqueta canónica (rel="canonical") es otra herramienta, con otro objetivo. Le indica a Google cuál URL preferís cuando hay copias o versiones muy parecidas. Es una señal, no una orden: Google puede elegir otra canónica si las señales no coinciden. Está documentado en Cómo especificar una URL canónica con rel="canonical" y otros métodos.
No uses noindex para juntar duplicados. noindex saca esa URL de la Búsqueda; no consolida sus señales en la versión que sí te importa. Para consolidar, la canónica (y, cuando una URL deja de existir, una redirección permanente) es el camino que documenta Google.
Arquitectura, enlaces internos y sitemap
Google descubre páginas siguiendo enlaces. Si una URL importante no está enlazada desde ninguna otra de tu sitio, depende de que alguien de afuera la enlace o de que aparezca en un sitemap. Las páginas huérfanas son un problema de arquitectura, no de más keywords.
Un menú claro, enlaces dentro del contenido y una jerarquía previsible (inicio, secciones, páginas) le muestran al rastreador qué existe y cómo se relaciona. Enlazar a la URL que considerás canónica, no a una copia con parámetros, refuerza esa preferencia.
El sitemap es una lista de URLs que querés que Google conozca. Ayuda a descubrir páginas, sobre todo en sitios grandes, nuevos o con poco enlace externo. No asegura que se rastreen ni que se indexen todas las que listás. Tener sitemap no reemplaza los enlaces internos.
Duplicados, parámetros y redirecciones
Cuando el mismo contenido vive en varias URLs, Google elige una versión canónica y tiende a tratar el resto como duplicados. Parámetros de seguimiento, filtros, versiones con y sin www o con y sin barra final suelen crear esas copias.
La señal canónica le dice cuál preferís. Si una URL vieja deja de existir, una redirección permanente le indica a las personas y a Google cuál es la nueva. No hace falta un tutorial de migración acá: si estás cambiando el sitio entero, el orden de ese trabajo está en cómo rediseñar el sitio sin perder SEO.
Tres reglas prácticas:
- Una idea, una URL preferida.
- Los parámetros que no cambian el contenido no deberían crear páginas indexables de más.
- Si movés una página, redirigila a su equivalente. No dejes que las dos convivan sin una preferencia clara.
Móvil, renderizado JavaScript y Core Web Vitals
La página que ve la persona en el celular es la que tiene que estar completa: texto, enlaces y acción principal. Si el contenido importante solo aparece en una versión de escritorio, o si un aviso tapa todo, el rastreador y el visitante se quedan cortos.
Cuando el contenido depende de JavaScript, Google no se queda en el HTML vacío: rastrea, renderiza y después indexa. Ese proceso está en los conceptos básicos del SEO en JavaScript. Si robots.txt bloquea los archivos JavaScript o de estilo, Google no puede renderizar bien la página. Los enlaces tienen que ser enlaces de verdad (una etiqueta con su dirección), no solo clics que inventa un script.
Las Core Web Vitals miden la experiencia de carga, interacción y estabilidad visual, como resume Web Vitals. Importan porque una página lenta o inestable es difícil de usar. No son un requisito para que Google indexe la URL: entrar al índice depende de que la página se pueda rastrear y de que Google decida guardarla. Tampoco son una garantía de posición. El detalle de qué medir y qué corregir primero está en qué medir en Core Web Vitals y qué arreglar primero.
Checklist de diagnóstico en Search Console: qué revisar primero y cuándo pedir ayuda
Si algo no aparece en Google, no empieces por reescribir el texto. Primero mirá si Google puede ver la URL y qué dice que está pasando.
Un orden útil en Search Console:
- Inspección de URLs de la página que te importa: si Google puede obtenerla, si hay un noindex, qué canónica detecta y si coincide con la que declaraste.
- El informe de indexación de páginas: cuántas están indexadas y, sobre todo, por qué se excluyen las demás (bloqueadas por robots.txt, con noindex, rastreadas pero no indexadas, duplicadas o con error).
- Acceso: errores del servidor, 404 inesperados, recursos bloqueados.
- Duplicados y parámetros: si Google eligió otra canónica, hay una pista de que las señales no están alineadas.
- Recién ahí, la experiencia (móvil, rendimiento). Eso mejora el uso; no desbloquea por sí solo una URL que no se puede indexar.
Este checklist sirve para encontrar frenos evidentes. No es una auditoría: no recorre el sitio página por página ni prioriza el trabajo de contenido, arquitectura y medición con el detalle de un entregable. Si necesitás ese alcance, está explicado en qué incluye una auditoría SEO y cómo leerla.
En ARTDEPARTMENT el diagnóstico rápido es el primer paso, sin costo, para ver los frenos principales. La auditoría completa es el trabajo pago, cuando hace falta ese informe más profundo. Ninguno de los dos reemplaza implementar los cambios en el sitio real.
Preguntas frecuentes
¿robots.txt saca una URL del índice?
No. robots.txt puede impedir el rastreo, pero no es la forma de desindexar. Para que una página no aparezca, usá noindex (y dejá que el rastreador la lea) o protegéla con un login.
¿El sitemap indexa solo?
No. El sitemap ayuda a descubrir URLs. Google no garantiza que rastree ni que indexe todo lo que el archivo lista.
¿Las Core Web Vitals son obligatorias para indexar?
No. No son un requisito de indexación ni una garantía de posición. Sirven para medir y mejorar la experiencia de la página.
¿Cuándo alcanza este checklist y cuándo hace falta una auditoría?
Este checklist alcanza para ver si Google puede rastrear e indexar el sitio y para detectar bloqueos evidentes en Search Console. Una auditoría hace falta cuando el problema no es un freno puntual, o cuando necesitás un informe página por página para priorizar el trabajo.
Para cerrar
El SEO técnico no posiciona por sí solo. Deja el sitio en condiciones de ser rastreado e indexado, que es el piso de todo lo demás. Si ese piso falla, el contenido útil no tiene cómo competir.
Pedí el diagnóstico SEO de tu sitio.
Fuentes
- Rastreo e indexación de Google (Google Search Central)
- Introducción a los archivos robots.txt (Google Search Central)
- Cómo afectan los códigos de estado HTTP a los rastreadores de Google (Google Search Central)
- Impedir que la Búsqueda indexe páginas con noindex (Google Search Central)
- Cómo especificar una URL canónica con rel="canonical" y otros métodos (Google Search Central)
- Qué es un sitemap (Google Search Central)
- Comprender conceptos básicos del SEO en JavaScript (Google Search Central)
- Web Vitals (web.dev)