
El SEO es optimizar un sitio para que Google lo rastree, lo indexe y lo muestre cuando alguien busca. En 2026 esa muestra cubre los resultados clásicos y las respuestas que Google y otros modelos de IA resumen o citan. No es un truco de keywords: es hacer que el sitio sea comprensible para un rastreador y útil para una persona.
Esta nota responde qué es el SEO y cómo funciona el SEO, sin ser un manual ni una página de servicio. Es el mapa.
¿Qué significa SEO?
SEO es Search Engine Optimization: optimizar para motores de búsqueda. En el uso cotidiano, “hacer SEO” se volvió un cajón donde entra de todo. En corto: qué es el SEO no es un plugin ni una campaña; es el oficio de hacer encontrable un sitio.
En la práctica es el conjunto de decisiones —técnicas, editoriales y de reputación— que hacen que un sitio pueda ser descubierto, entendido y recuperado cuando alguien busca. El interlocutor principal sigue siendo Google, que concentra la mayor parte de la búsqueda web en Argentina y en el mundo.
Tres capas, siempre las mismas:
- Que el rastreador entre y recorra las URLs que importan.
- Que el índice conserve esas URLs como documentos útiles, no como duplicados o ruido.
- Que, dada una consulta, el sistema elija mostrar o citar ese documento.
El mecanismo de fondo no se reinventó desde los años noventa: crawler, índice, ranking. “On-page” y “técnico” son recortes para organizar el trabajo, no disciplinas separadas. Un H1 mal puesto es editorial y técnico a la vez. Un canonical que apunta a la home es un error de indexación disfrazado de contenido.
En ART DEPARTMENT vemos el SEO desde dos lados del mismo producto: el texto y el código que lo sirve. Un párrafo claro no alcanza si la plantilla de WordPress lo duplica en treinta archivos, si el servidor responde lento al crawler o si el robots.txt bloquea la sección que querés indexar. Esa mirada —plantilla, HTML servido, Search Console de Google— recorre esta nota.
¿Cómo funciona: rastreo, índice y ranking?
Google no “visita” tu sitio como una persona. La Búsqueda funciona en tres etapas —rastreo, indexación y entrega de resultados— y no todas las páginas pasan por cada una. Un rastreador —Googlebot, y también bots de Microsoft, Apple y de modelos de IA— pide URLs, descarga HTML, sigue enlaces, interpreta recursos. Ese paso se llama rastreo. Después viene el índice: el catálogo de documentos del que salen las respuestas. El ranking es la tercera etapa: dada una consulta, el sistema recupera candidatos y los ordena. En 2026 ese orden no es solo diez links. Puede incluir un resumen generado, un carrusel, un mapa, un video. Eso es cómo funciona el SEO según la documentación de Google: rastreador, índice, resultado.
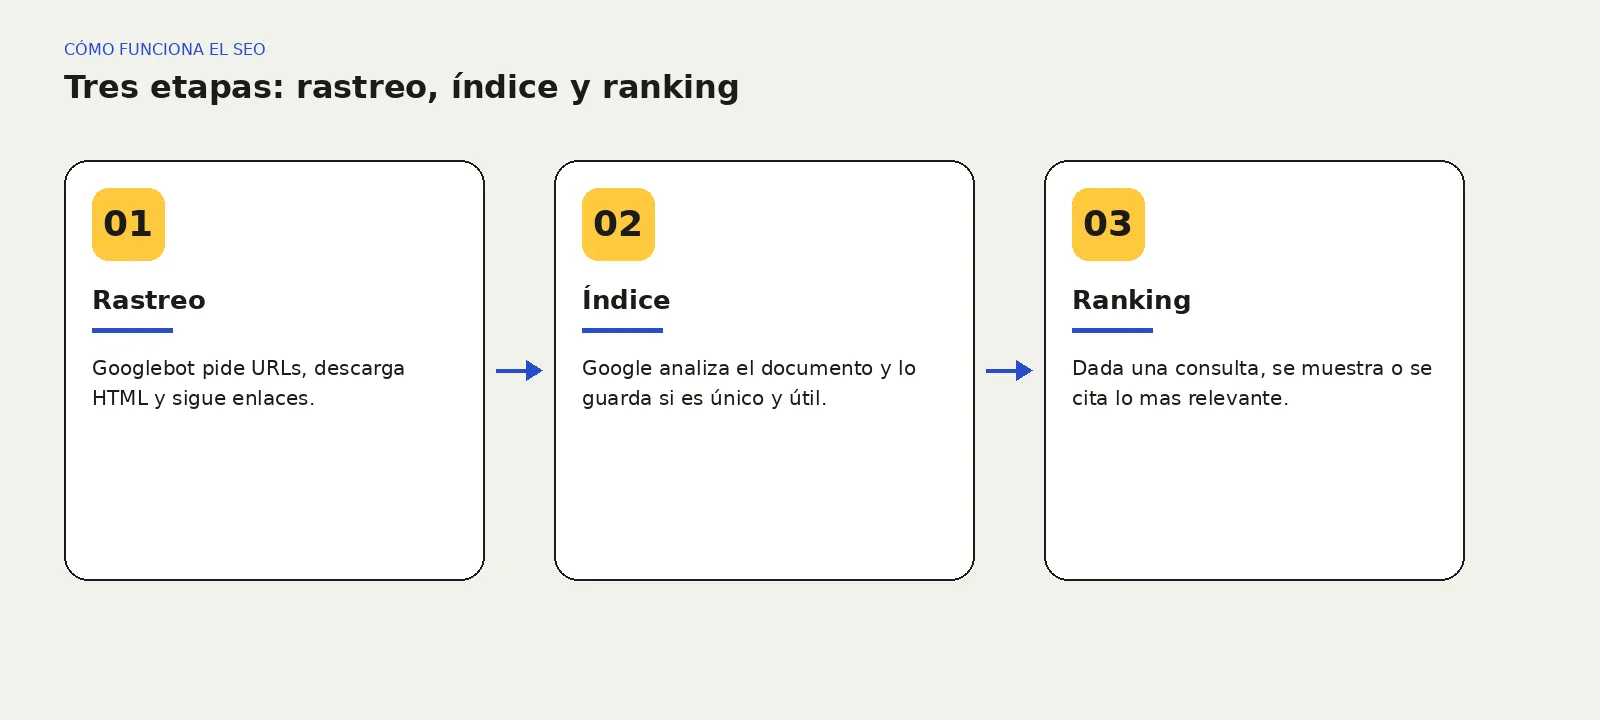
*Rastreo, índice y publicación: el circuito que Google documenta.*
Rastreo
El rastreador necesita una puerta de entrada: un enlace desde una página ya conocida, un sitemap, una URL enviada en Search Console de Google. Recorre el grafo de enlaces internos. Sitios desordenados lo descubren tarde: el crawler gasta presupuesto en filtros y paginaciones, y no llega a las URLs que sí importan.
Se rompe por cosas concretas. Un `robots.txt` que bloquea /blog/. Un JavaScript que pinta el contenido después de un cliente que Googlebot no espera. Un hosting que responde 5xx o tarda tanto que el bot recorta. Canonicals que mandan a otro host. Enlaces internos que no existen en el HTML, solo en un menú inyectado.
Una observación de quien mira logs y plantillas: el HTML que ves en el navegador no siempre es el que se le sirve al bot. Un plugin de caché, un CDN o un theme que cambia el markup según user-agent pueden dejar dos sitios. Search Console de Google muestra uno. El inspector de tu notebook, otro. El trabajo técnico empieza por alinear esas dos lecturas, no por instalar otro plugin.
Índice
No todo lo rastreado entra. Google decide si la página es única, si responde a algo, si está disponible, si no es una copia barata de otra URL. El índice de Google guarda el documento con señales: título, encabezados, enlaces, idioma, fecha, entidades, experiencia de la página.
Tres estados que se confunden:
- Rastreado no es indexado. Podés ver hits de Googlebot en el servidor y, igual, la URL en “Rastreada: actualmente sin indexar”.
- Indexado no es visible. Hay páginas en el índice que casi no reciben impresiones porque no ganan ninguna consulta.
- Visible no es citado. Una URL puede aparecer en los resultados clásicos y no entrar a una Vista creada con IA, o al revés, si el modelo eligió otra fuente. En el índice de Google conviven páginas útiles y ruido; el trabajo es que las tuyas no sean ruido.
La indexación es, en muchos sitios, el cuello de botella real. Publicar más notas no resuelve una cobertura rota. Lo que la resuelve es entender por qué el índice rechaza: duplicados de plantilla, contenido fino, canonicals en cadena, parámetros, HTTP vs HTTPS, o un `noindex` olvidado en un entorno de prueba.
Ranking
El ranking compara documentos del índice de Google contra una consulta. Usa cientos de señales; Google no publica la receta. Lo que sí documenta alcanza para no trabajar a ciegas: relevancia, calidad, experiencia de página y el contexto del sitio entero, no de la URL aislada.
Optimizar “una keyword” como palanca independiente suele fallar. La consulta es un proxy de una intención. El documento que gana es el que cubre esa intención mejor que los otros candidatos. Por eso una guía informativa y una landing comercial no deberían ser la misma URL.
¿Qué mira Google en 2026?
El SEO en 2026 no tiene una lista pública y completa de factores. Google publica lineamientos y documentación para desarrolladores. Para operar un sitio, alcanza un mapa de criterios.
Intención
Cada consulta tiene una intención: entender, comparar, hacer, ir a un lugar, resolver un error. Google intenta servir la página que mejor cubre esa intención, no la que más veces repite la palabra. Esta nota cubre qué es el SEO y cómo funciona el SEO. Una página de servicio responde quién puede hacerlo sobre tu sitio. Mezclar las dos intenciones produce un híbrido que no cita bien ni convierte bien.
E-E-A-T
Experiencia, pericia, autoridad y confianza (Experience, Expertise, Authoritativeness, Trust). No es un factor de clasificación específico. Es un marco: ¿quién escribe, con qué práctica, en qué sitio, con qué señales verificables?
En 2026, con resúmenes de IA, ese marco pesa más porque el modelo prefiere citar fuentes que puede atribuir. Fechas, autores reales, datos concretos y páginas que no prometen lo que no pueden cumplir ayudan. E-E-A-T no se “implementa” con un bloque de autor copiado: el sitio tiene que hablar de lo que practica. Si ART DEPARTMENT dice que mira crawl y plantillas, esta nota sobre el SEO en 2026 tiene que leerse como escrita por gente que abre Search Console y el HTML.
Experiencia de la página
Core Web Vitals, HTTPS, usabilidad móvil, estabilidad visual. Google mide si la página es usable, no solo si el texto es largo. Desde el servidor se ve la otra cara: TTFB alto, HTML inflado por el tema, CSS que bloquea el primer pintado. Un crawler paciente no es lo mismo que una persona en 4G. En WordPress esto se juega en el theme, los plugins y el hosting. Un TTFB de dos segundos no se arregla reescribiendo el H1.
Enlaces y menciones
Los enlaces siguen siendo una señal de que otras páginas consideran la tuya relevante. También lo son las menciones sin link y las citas. Comprar links o armar redes de sitios chatarra choca con las políticas de spam de Google. Google mira el sitio como conjunto: un dominio que publica a escala sin valor arrastra a las URLs buenas. La reputación no es el puntaje de una herramienta de terceros; es el patrón que el índice de Google ya aprendió sobre ese host.
¿Qué cambió el SERP: links, Vistas creadas con IA, citas en LLMs?
El SERP de 2016 era, en gran medida, una lista. El de 2026 es un tablero. Google mezcla resultados clásicos, Vistas creadas con IA (AI Overviews), bloques de imágenes, videos, mapas y foros. Una parte de las búsquedas ya no pasa por Google: la persona le pregunta a ChatGPT, Gemini, Perplexity o Claude. Esos sistemas recuperan fuentes, las resumen y a veces las citan. El SEO en 2026 convive con Overviews y con diez links; no son canales distintos. Para ver cuántas veces tus URLs aparecen en features de IA generativa de Google (impresiones, páginas, países, dispositivos), está el informe de IA generativa en Search Console.
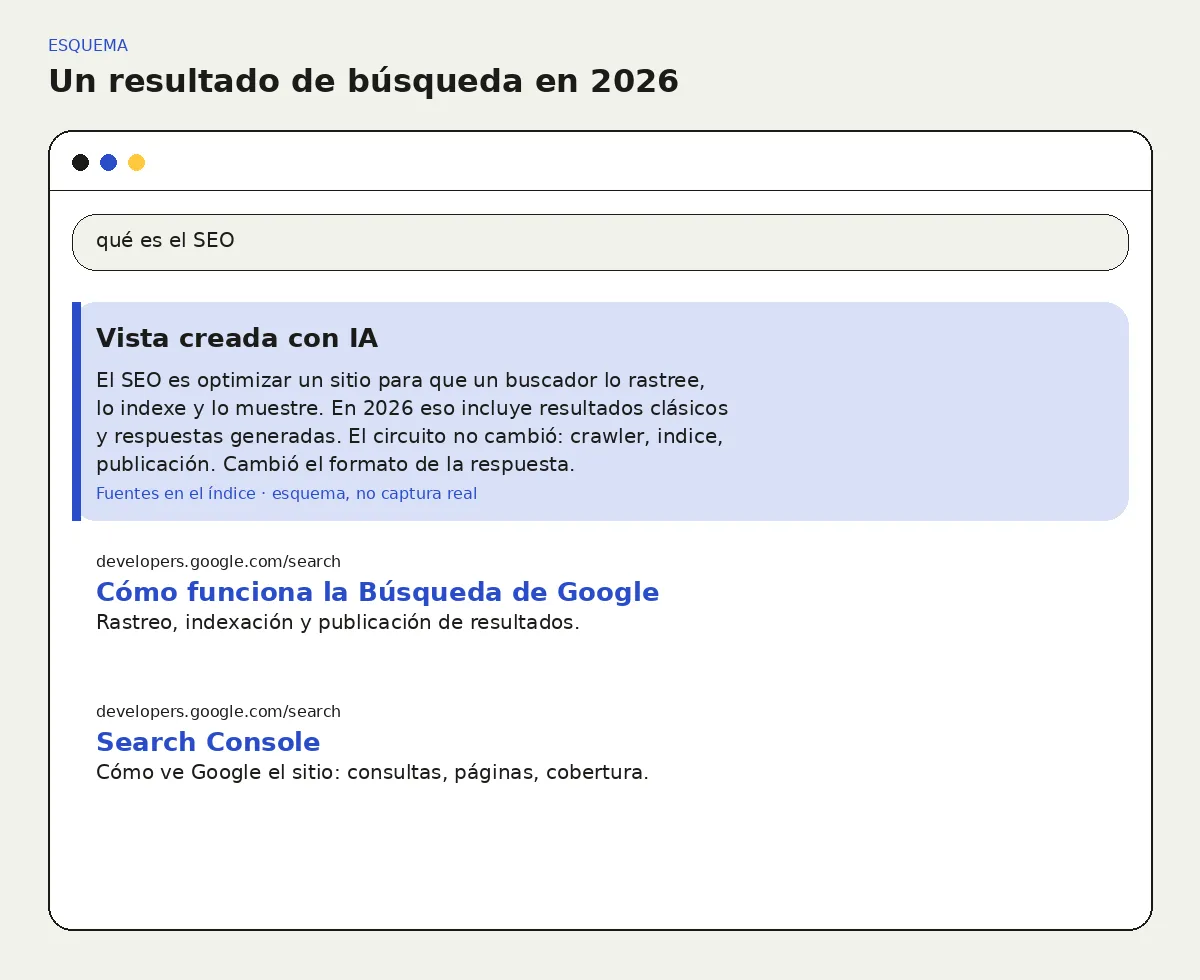
*Esquema. La Vista creada con IA sale de documentos indexados.*
GEO —optimización para motores generativos— es el nombre de mercado de esa extensión. No es un canal nuevo con reglas mágicas. Es el mismo circuito alargado: rastreo o ingestión, índice o memoria, recuperación y cita. Si el sitio no se puede rastrear o no se entiende, tampoco se cita.
Qué implica para cómo se escribe, sin convertir esta nota en un artículo de GEO:
- El primer párrafo tiene que poder citarse. Una definición con entidad y fecha se reutiliza mejor que un preámbulo de agencia.
- Los H2 en forma de pregunta coinciden con cómo la gente busca y con cómo los modelos fragmentan un texto.
- Las listas de criterios o de pasos se extraen fácil. Un ensayo de adjetivos, no.
- Las entidades con nombre —Google, Search Console, WordPress, ART DEPARTMENT, 2026— anclan el texto a cosas verificables.
- Si el sitio bloquea bots de IA o sirve un HTML vacío al crawler, no hay cita posible.
Nada de esto cambia cómo funciona el SEO: sigue siendo rastreo e índice. Un Overview de Google sigue saliendo de documentos indexados. Un LLM que cita tu dominio tuvo que leerlo o recuperarlo. El circuito se alargó; no se inventó otro. El clic sigue importando para el negocio; la cita, para la marca. Las dos salen del mismo HTML.
¿Cuáles son los tres frentes: técnico, contenido y autoridad?
El trabajo se agrupa en tres frentes. No son departamentos estancos. Un cambio en la plantilla es técnico y de contenido a la vez.
Técnico
Arquitectura de URLs, rastreo, indexación, canonicals, datos estructurados con mesura, rendimiento, logs, Search Console. En WordPress, gran parte de este frente vive en el tema y en cómo se generan archivo, ficha, tag y paginación. Un plugin de SEO edita metadatos; no decide si el loop del archivo indexa mil páginas vacías. En un desarrollo a medida el mismo problema vive en el router o en el HTML que el framework manda. La pregunta no cambia: ¿qué ve el crawler cuando pide esta URL?
El hosting entra acá. Si el servidor tarda o se cae, el crawler recorta. Quien opera WordPress en serio mira TTFB, caché y disponibilidad con el mismo ojo con el que mira el sitemap.xml. El hosting WordPress administrado es, en esos casos, infraestructura de indexación tanto como de uptime.
Contenido
Intención, estructura, entidades, fechas, autoría, enlazado interno. No es “subir posts”. Es decidir qué URL existe para qué consulta, qué no debería existir, y cuál es la canónica cuando dos URLs se pisan. El enlazado interno le dice al crawler qué es importante y a la persona por dónde seguir.
Si necesitás la mecánica de ranking o cómo trabajar una URL concreta, hay otras guías en el blog. Acá el foco es qué es el SEO.
Autoridad
Enlaces, menciones, marca, consistencia del dominio en el tiempo. Un sitio nuevo puede estar bien rastreado y bien escrito y, igual, tardar en ganar consultas competitivas porque el índice compara contra dominios con historial. Los tres frentes se miden juntos. Arreglar lo técnico sin contenido deja un sitio limpio que no responde nada. Publicar sobre un sitio que el índice de Google no acepta es escribir para el vacío. Perseguir enlaces con páginas débiles es ruido.
¿Qué no es SEO?
La sigla se usa para vender casi cualquier cosa.
No es publicidad paga. Google Ads compra visibilidad mientras dura el presupuesto. El SEO trabaja sobre visibilidad orgánica. Se complementan; no son lo mismo. Cuándo priorizar cada uno —y cuándo ambos— está en SEO o Google Ads: pauta u orgánico.
No son redes sociales. Un post en Instagram o LinkedIn puede mandar tráfico. No indexa tu sitio ni construye el ranking de una URL, salvo que alguien enlace de verdad.
No es comprar links. Las redes de blogs y los paquetes de backlinks chocan con las políticas de spam de Google. El atajo sale más caro que no haberlo hecho.
No es un plugin. Yoast, Rank Math o el SEO nativo de un CMS ayudan a editar un title o un canonical. No rastrean, no indexan, no escriben, no arreglan la plantilla. Instalarlos y poner la lucecita en verde no es haber hecho el trabajo.
No es rellenar keywords. Repetir “SEO” veinte veces no le explica nada al rastreador que un H1 claro y un párrafo de definición no le hayan explicado ya.
No es garantizar un puesto. Nadie controla el índice ajeno, la competencia ni los cambios de Google. Un equipo serio puede explicar qué va a mirar y con qué métricas. No puede firmar el primer resultado.
¿Cómo se mide?
La herramienta central sigue siendo Search Console de Google. No es la única —hay logs, crawlers propios, analytics— pero es la que te dice cómo Google ve el sitio, no cómo lo imaginás.
Cuatro recortes útiles:
- Consultas. Qué buscó la gente cuando se mostró tu URL, con impresiones, clics y posición media. Sirve para ver intención real, no la keyword que vos creías.
- Páginas. Qué URLs reciben impresión. Ahí se ve si el archivo le gana a la nota, si una ficha canibaliza a otra, si la home se come consultas que deberían ir a un servicio.
- Indexación. Cobertura: indexadas, rastreadas no indexadas, excluidas por canonical, bloqueadas por robots, duplicadas. Si esta pestaña está mal, el resto del informe miente por omisión.
- Experiencia. Core Web Vitals, HTTPS, usabilidad. No reemplaza Lighthouse en local, pero sí muestra el recorte que Google usa a escala.
Cuando Search Console de Google dice “descubierta, no indexada”, no se responde con más texto. Se abre la URL, se mira el HTML servido y si el tema imprimió un noindex heredado. El diagnóstico es técnico antes de ser editorial.
¿Cuándo pasa a un equipo?
Hay un punto en el que el mapa de esta nota no alcanza. No es un tamaño de empresa: es un tipo de problema.
Pasa a un equipo cuando el sitio ya tiene demanda y no aparece, o aparece para consultas que no sirven; cuando la cobertura de indexación está rota; cuando hay mil URLs de plantilla y nadie sabe cuáles deberían existir; cuando el contenido se publica y Search Console de Google no lo ve.
En ART DEPARTMENT ese trabajo no es un informe que otro tiene que implementar. Miramos rastreo, plantillas e indexación sobre el sitio real —en WordPress o en un desarrollo a medida— y priorizamos el freno, no una lista genérica. Si el equipo acelera research y drafts con agentes, el criterio people-first no cambia: el playbook Cómo usar Grok Bot en SEO, contenido y Ads separa insumos del publish gate. Si lo que necesitás es el trabajo de SEO que una agencia hace sobre el sitio, ahí está el recorte operativo: diagnóstico, técnico, contenido y medición, con el mismo equipo que también sostiene hosting y código.
Qué es el SEO y cómo funciona el SEO en 2026 sigue siendo eso: un sitio que un rastreador puede entender y que una persona puede usar. El resto son formatos de la respuesta.