Posicionar una página en Google es hacer que una URL concreta pueda ser rastreada, indexada y elegida para consultas reales. No es un truco de keywords ni un plugin en verde: es trabajo sobre el HTML que ve Googlebot, la intención de la página y la medición en Search Console.
Esta guía es un how-to accionable para una URL. El mapa del circuito —rastreo, índice, ranking— está en qué es el SEO y cómo funciona en 2026. Aquí se opera sobre una página.
¿Qué significa posicionar una página en Google?
Posicionar una página no es “estar en Google”. Indexado no es visible. Visible no es primero. En la documentación de Google, la Búsqueda funciona en tres etapas —rastreo, indexación y entrega— y no todas las páginas pasan por cada una. Posicionar, en la práctica de producto, es dejar a una URL lista para esa comparación: descubrible, comprensible y competitiva para una intención.
Definición operativa: una página está posicionable cuando (1) Googlebot puede pedirla y leer el contenido principal, (2) el índice la acepta como documento útil y canónico, y (3) el documento responde mejor que otros candidatos a consultas reales que la gente escribe. Sin (1) y (2), el title no cambia nada. Sin (3), hay índice y no hay impresiones útiles.
En ART DEPARTMENT eso se lee en la plantilla y en el HTML servido. Un H1 claro con un bloque de precios heredado del theme es un documento ambiguo. El índice guarda ese lío. El ranking elige otro candidato. El oficio es decidir qué URL existe para qué intención y qué markup se le sirve al bot.
Google no garantiza rastreo, indexación ni publicación. Tampoco acepta pagos para rastrear más seguido o clasificar más alto. Quien vende el puesto no está vendiendo posicionamiento de una página: está vendiendo otra cosa.
¿Cómo pasa una URL de publicada a elegible?
El proceso que importa para una sola página es lineal y verificable:
- Existe una URL canónica con una intención.
- Es rastreable: enlaces, sitemap, HTTP 200, sin bloqueos absurdos.
- Es indexable: sin
noindexindeseado, sin duplicado que gane el clúster. - Es relevante: title, H1, primer párrafo y cuerpo alineados con la consulta.
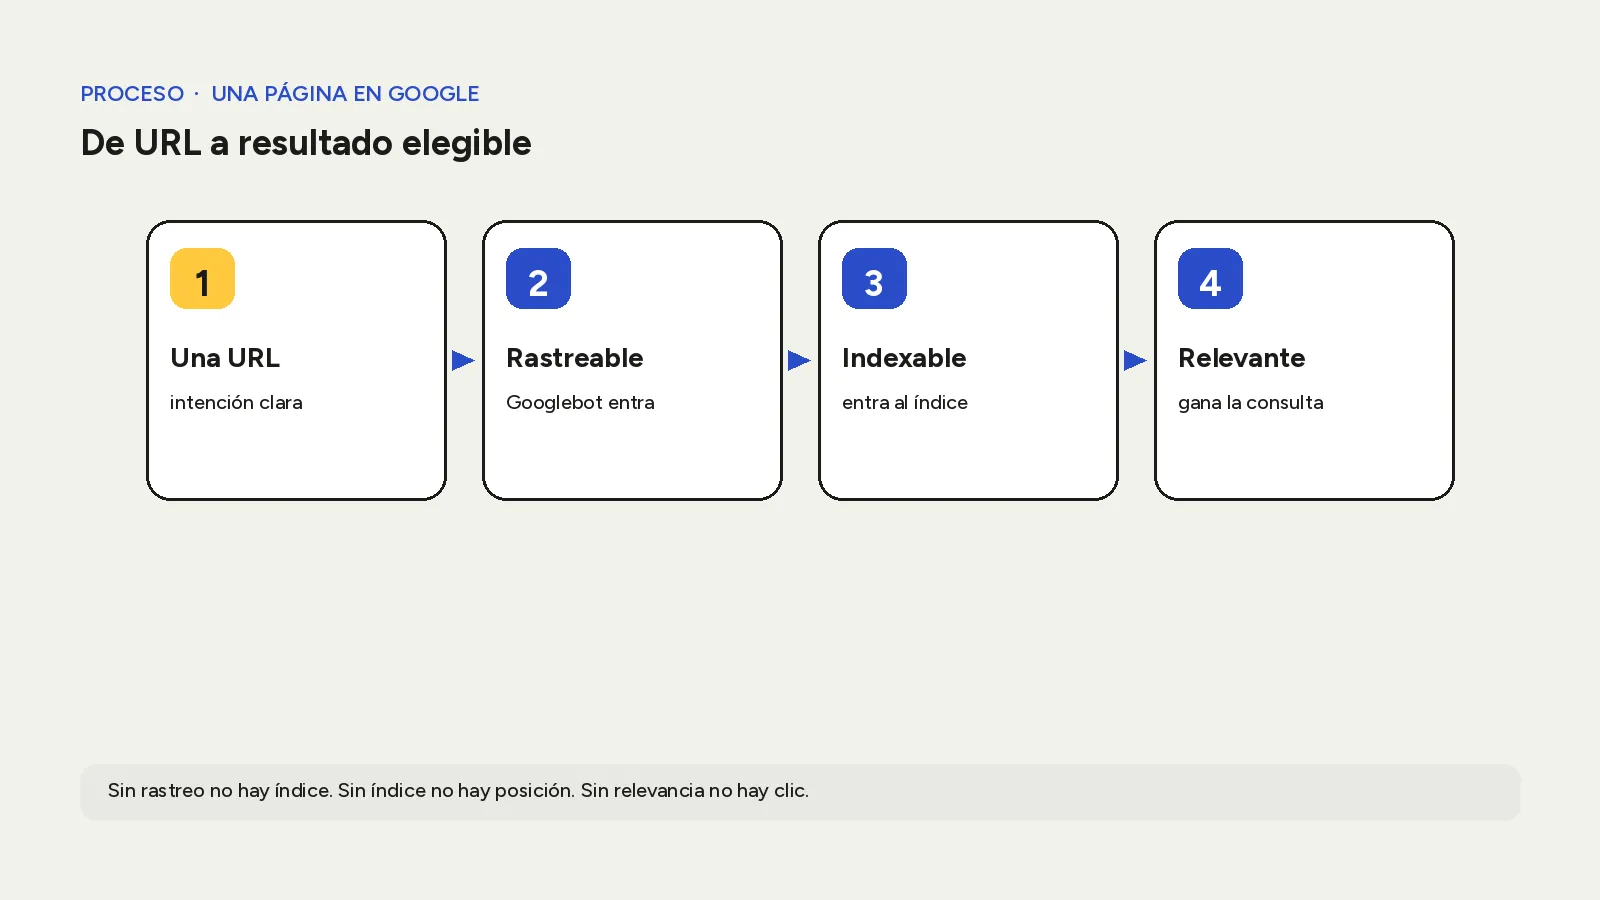
*Una URL → rastreable → indexable → relevante para una consulta. Sin los tres primeros estados no hay “posición” que optimizar.*
Ese diagrama es el checklist. El resto de la nota detalla cada casilla con lo que Google documenta y con lo que se ve al abrir Search Console y el HTML.
¿Qué tiene que existir antes de optimizar el texto?
Sin rastreo no hay documento. Sin índice no hay candidato. Optimizar el copy de una URL que Google no indexa es teatro. El circuito completo está en la nota sobre qué es el SEO; aquí solo el prerrequisito para una página.
Compruebe primero si Google ya conoce la URL. La guía de inicio de SEO de Google lo formula así: busque con el operador site: y, si no aparece, revise requisitos técnicos antes de reescribir títulos. Para el estado de indexación del sitio, el informe de indexación de páginas en Search Console separa indexadas de no indexadas y explica motivos. La inspección de URL mira una página concreta; el informe mira el patrón.
Tres fallos que se disfrazan de “no posicionamos”:
- El rastreador no entra.
robots.txt, login, 5xx, JavaScript que deja el cuerpo vacío para Googlebot. - Entra y el índice rechaza. Duplicados de plantilla, contenido fino,
noindexheredado, canonicals en cadena. - Indexa y no gana ninguna consulta. El documento existe; para las búsquedas reales pierde la comparación.
El HTML del navegador no siempre es el que se le sirve a Googlebot. Caché, CDN o un theme que cambia el markup según user-agent dejan dos sitios. Search Console muestra uno; el inspector del notebook, otro. Alinear esas lecturas es prerrequisito, no una palanca estética.
¿Cómo se elige una URL por intención?
Una página en Google no gana “la keyword”: gana (o pierde) un tipo de pregunta. La guía de inicio de SEO insiste en organizar el sitio de forma lógica, usar URLs descriptivas y reducir duplicados: una pieza de información, una URL preferida.
Regla práctica para una URL:
- Una intención principal por documento. “Qué es X” y “contratar X” no deberían ser el mismo HTML.
- Un H1 que nombre esa intención sin gritar.
- Enlaces internos desde páginas relacionadas que ya reciben rastreo.
- Canonical explícito cuando existan variantes (HTTP/HTTPS, parámetros, AMP, impresión).
En WordPress el riesgo es de plantilla: archivo, tag, paginación y ficha que repiten el mismo bloque. En un desarrollo a medida el riesgo es de router: query strings y vistas que generan clones. En ambos casos la decisión es editorial y técnica a la vez: qué URL debe ser la canónica y qué se redirige o se deja como alternativa.
Si dos URLs pelean la misma consulta, Search Console lo muestra en rendimiento (impresiones repartidas) y a menudo en indexación (duplicada / canónica elegida por Google). Resolver canibalización es posicionar: consolidar, no publicar otra variante.
¿Cómo se trabaja el on-page de una página?
El on-page de una URL es el contrato entre el documento y la consulta. Google genera el vínculo de título a partir de varias fuentes —elemento title, H1 visible, encabezados, og:title, texto destacado— y puede reescribirlo si el title es genérico, repetido o engañoso. Influir no es forzar: es escribir un título único, claro y fiel al cuerpo.
Checklist on-page para una URL:
- Title. Único en el sitio. Describe la página. Incluye la entidad o la pregunta principal. Evite el relleno de keywords: Google lo marca como mala práctica y como spam de relleno.
- H1. Un título principal visible, alineado con el
titlesin ser un clon vacío. Si la plantilla imprime dos H1 del mismo peso, el documento queda ambiguo. - Primer párrafo. Definición citable en 40–80 palabras. Dice qué es, para quién y qué no es. Sirve a la persona y a los sistemas que resumen.
- Encabezados. H2 (y H3 si hace falta) en forma de preguntas o de pasos que la gente busca. No hace falta un número mágico de headings; hace falta estructura legible.
- Contenido principal en HTML. El texto que importa debe estar en el DOM que Googlebot procesa, no solo en un canvas o en un fetch posterior frágil.
- Metadescripción. No clasifica por sí sola; ayuda al snippet cuando Google la usa. Una frase útil por página, no un eslogan de marca repetido.
- Imágenes con alt descriptivo. Cerca del texto relevante, como indica la guía de inicio.
En ART DEPARTMENT el on-page se valida abriendo el HTML servido: ¿el title del <head> coincide con lo que edita el CMS? ¿el theme inyectó un H1 de archivo encima del H1 del post? ¿el primer bloque útil está debajo de un hero vacío para el bot? Esas preguntas valen más que un checklist de plugin.
Un error frecuente: optimizar el title de la home para una consulta que debería ganar una URL de servicio. La home puede rankear para marca; rara vez debería ser la única apuesta para “cómo hacer X”. Si el rendimiento muestra que la home absorbe impresiones informativas, el enlazado interno y el H1 de la guía tienen que reclamar esa intención con un documento mejor, no con más keywords en la portada.
Datos estructurados: si la pieza es un artículo, el tipo Article en schema.org describe headline, autor, fechas. Google documenta datos estructurados de artículo para elegibilidad de funciones, no como atajo de ranking. Marcar FAQPage sin FAQ real es ruido. Esta nota usa Article, no FAQPage.
¿Qué es el contenido útil para posicionar una página?
Los sistemas de clasificación priorizan información útil y confiable creada para personas, no contenido fabricado para manipular el buscador. Google ofrece preguntas de autoevaluación: ¿hay originalidad? ¿cubre el tema con sustancia? ¿el título describe sin gritar? ¿alguien lo guardaría?
E-E-A-T (experiencia, pericia, autoridad, confianza) no es un factor de clasificación específico. Es un marco. La confianza pesa más. Demostrar experiencia en una página de producto puede ser una prueba real; en una guía técnica, el detalle verificable del HTML y de Search Console.
Contenido que prioriza el motor —producción masiva, sin valor añadido, fechas maquilladas, promesas sin respuesta— es exactamente lo que la documentación pide evitar. Google tampoco tiene un recuento de palabras preferido. Una página corta que resuelve puede ganar a un ensayo vacío.
En la práctica de agencia que también escribe código:
- Cite fuentes primarias (Search Central, web.dev, schema.org), no blogs que paraphrasan a Google.
- Muestre el oficio: plantilla, log, informe. No invente casos ni porcentajes.
- Actualice cuando cambie el producto o la documentación, no para “parecer fresco”.
¿Cómo entra la experiencia de página y Core Web Vitals?
Los sistemas principales buscan recompensar contenido con buena experiencia de página. No hay un único indicador. La relevancia sigue ganando: una página útil puede mostrarse aunque la experiencia sea deficiente. Cuando hay muchos documentos útiles para la misma consulta, la experiencia puede decidir.
Las Métricas web esenciales —LCP, INP, CLS— miden carga, interactividad y estabilidad con datos de usuarios reales. Google recomienda umbrales buenos (LCP en 2,5 s, INP bajo 200 ms, CLS bajo 0,1). El informe de campo en Search Console importa más que un Lighthouse local verde. La iniciativa Web Vitals en web.dev detalla medición en campo y laboratorio.
Desde el servidor se ve la otra cara. TTFB alto, HTML inflado por el theme, CSS que bloquea el primer pintado, imágenes sin tamaño. En WordPress eso vive en el tema, los plugins y el hosting. Un TTFB de dos segundos no se arregla reescribiendo el title. El hosting WordPress administrado entra aquí como infraestructura de experiencia —y de rastreo—, no como un extra de uptime.
HTTPS, usabilidad móvil y evitar intersticiales intrusivos forman parte del mismo recorte. Experiencia de página no es “pasar Core Web Vitals y listo”: es que una persona pueda leer y actuar sin pelearse con la interfaz.
¿Qué mirar en Search Console para una URL?
Search Console es el servicio gratuito que muestra cómo Google ve el sitio. No hace falta para aparecer en la Búsqueda; sí hace falta para diagnosticar.
Para posicionar una página, el flujo útil es:
- Inspección de URL. ¿Está en el índice? ¿Cuál es la canónica elegida? ¿Googlebot obtuvo el HTML esperado?
- Indexación de páginas. Si la URL cae en “Rastreada: actualmente sin indexar” o “Descubierta: actualmente sin indexar”, el problema no es el H2: es cobertura. El informe de indexación lista motivos.
- Rendimiento. Consultas, impresiones, clics, CTR, posición media para esa página. Ahí se ve la intención real, no la keyword inventada en un brief.
- Core Web Vitals. Recorte de campo por grupo de URLs.
- Enlaces. Internos y externos que Google conoce.
Solicitar indexación puede acelerar un recrawl; no garantiza inclusión. Un sitemap ayuda al descubrimiento, sobre todo en sitios grandes o nuevos, pero no sustituye enlaces internos ni contenido útil.
Cuando Search Console dice que la página está indexada y no aparece para la consulta deseada, el trabajo pasa a relevancia y competencia: mejorar la página, no martillar “volver a indexar”.
También conviene mirar la cobertura móvil. Google indexa principalmente con el rastreador de smartphone. Si la plantilla oculta el cuerpo en viewport móvil o sirve un layout distinto que pierde el H1, la URL “bien vista” en desktop puede estar débil en el índice que importa. La inspección de URL permite comparar HTML obtenido; no asuma que el theme mobile es inocente.
¿Cómo ayudan los enlaces internos?
Google encuentra la mayoría de las URLs siguiendo vínculos. Los enlaces rastreables —preferiblemente <a href> con texto de anclaje descriptivo— conectan el grafo. Un menú solo en JavaScript sin URL real, o un botón sin href, no construye el mismo camino.
Para una página que se quiere posicionar:
- Enlace desde la home o desde un hub temático si es estratégica.
- Enlace desde 2–5 páginas relacionadas del mismo tema, con anclas que describan el destino (“cómo funciona el SEO”, no “clic aquí”).
- Evite huérfanas: publicadas y nunca enlazadas.
- No fabrique redes de pie de página con keywords. Eso roza spam de vínculos.
El enlazado interno también aclara el sitio a la persona. Si la guía de conceptos no apunta al how-to, el lector (y el bot) se quedan a medias. Por eso primero enlazamos el mapa de qué es el SEO, y el servicio solo al final, cuando ya quedó claro qué problema estás mirando.
¿Qué no hacer al posicionar una página?
Las políticas de spam de la Búsqueda listan prácticas que bajan o eliminan elegibilidad: encubrimiento, páginas de entrada, relleno de keywords, spam de vínculos, contenido a gran escala sin valor, scraping, redirecciones engañosas, afiliación engañosa, entre otras.
Lista corta de “no” para una URL:
- No comprar enlaces ni intercambiar enlaces solo para ranking.
- No servir un HTML al bot y otro a la persona (cloaking).
- No rellenar el title o el cuerpo con la misma frase.
- No generar decenas de páginas casi idénticas “para ciudades”.
- No copiar guías ajenas sin aportar práctica.
- No prometer el primer puesto.
- No confundir Ads con orgánico: se complementan; no se sustituyen en el informe de rendimiento orgánico.
El borde importa porque el atajo sale más caro que no haberlo hecho: acciones manuales, pérdida de confianza del dominio y tiempo perdido en deshacer.
¿Cuándo medir si la página posicionó?
La guía de inicio advierte que los cambios pueden verse en horas o en meses; en general conviene esperar semanas antes de juzgar. No todo cambio produce un efecto notable.
Cómo medir sin autoengaño:
- Fije la URL y 3–10 consultas objetivo (o dejen que Search Console muestre las reales).
- Anote estado de indexación antes y después.
- Mire impresiones y clics en ventanas comparables (28 días vs 28 días), no un día aislado.
- Separe brand de no brand si el volumen lo permite.
- Si no hay impresiones, vuelva a rastreo/índice. Si hay impresiones y poco clic, revise title/snippet. Si hay clic y no convierte, el problema ya no es Google.
Posicionar una página es iterativo. Una mejora de LCP, un H1 más preciso y tres enlaces internos pueden mover más que reescribir el artículo entero sin diagnóstico.
En sitios con mucho JavaScript, valide el render. Googlebot procesa JS con un Chrome reciente, pero el contenido crítico no debería depender de una carrera frágil. Si el primer párrafo útil aparece solo después de tres requests fallidas, la página puede indexarse mal o tarde. Preferir HTML sustancial en la respuesta inicial no es nostalgia: es elegibilidad.
¿Cuándo alcanza con esta guía y cuándo pedir ayuda?
Esta nota alcanza cuando hay una URL clara, el sitio responde, Search Console está verificado y el bloqueo es de claridad editorial o de higiene técnica básica. Deja de alcanzar cuando la cobertura está rota a escala, cuando mil plantillas pelean canónicas, cuando el HTML que ve Googlebot no es el del CMS, o cuando el negocio necesita priorizar un portafolio entero de URLs.
En ART DEPARTMENT el SEO no es un PDF que otro implementa. Se mira plantilla, HTML a Googlebot y Search Console sobre el sitio real —WordPress o a medida—. Si lo que hace falta es el trabajo de posicionamiento web sobre el sitio, ahí está el recorte operativo: diagnóstico, técnico, contenido y medición, con el mismo equipo que también sostiene código y hosting.
Posicionar una página en Google, en 2026, sigue siendo eso: una URL que el rastreador puede entender, que el índice acepta y que una persona elige cuando busca. El resto es disciplina para no confundir el informe con el deseo.