El query fan-out de Google es un conjunto de consultas relacionadas que el modelo dispara en paralelo para reunir más resultados útiles y sostener una respuesta en features de IA (como AI Overviews y AI Mode). No es una lista de URLs que tengas que inventar: es una técnica de recuperación. La guía oficial lo define así en la optimización para features de IA generativa.
¿Qué es el query fan-out?
En el glosario de esa guía, Google llama query fan-out a un set de consultas concurrentes y relacionadas que genera el modelo para pedir más información y traer resultados adicionales que ayuden a responder la consulta de la persona.
El ejemplo que usan es el del césped: si alguien pregunta cómo arreglar un césped lleno de malezas, el fan-out puede incluir cosas como mejores herbicidas, métodos sin químicos y cómo prevenir malezas. No son “keywords que tenés que rankear con tres landings clon”; son caminos de recuperación que el sistema usa para ampliar el universo de páginas candidatas.
Traducción editorial: cuando Search arma una respuesta con IA, a menudo no se queda solo con la consulta literal. Explora subtemas y fuentes en paralelo. Tu página puede entrar por la consulta original o porque es una buena respuesta a una de esas consultas satélite. Eso no cambia la base de cómo rankea Google una página en 2026: relevancia, calidad e indexación siguen mandando.
Eso también explica por qué a veces ves en un Overview un sitio “inesperado”: no necesariamente ganó la keyword head; puede ser la mejor página recuperada para un subtema del fan-out. La pregunta útil no es “¿cómo adivino las fan-out queries internas?”, sino “¿mi URL es la mejor respuesta para el núcleo del tema y para los matices que un lector serio va a necesitar?”.
¿Dónde aparece (AI Overviews y AI Mode)?
Google documenta que tanto AI Overviews como AI Mode pueden usar la técnica de query fan-out: lanzan búsquedas relacionadas sobre subtemas y fuentes de datos para armar la respuesta. Mientras se genera, los modelos avanzados identifican más páginas de soporte, lo que permite mostrar un set de enlaces más amplio y diverso que en un resultado web clásico. Eso está en AI features y tu sitio.
Hay dos matices importantes:
- AI Overviews y AI Mode pueden usar modelos y técnicas distintas, así que los enlaces (y a veces el ángulo de la respuesta) no tienen por qué coincidir entre uno y otro.
- Los Overviews no se disparan siempre. Google indica que aparecen cuando el sistema considera que aportan algo más allá del Search clásico.
En la práctica, “aparecer” suele ser: tu URL figura como link de soporte de una respuesta generada. El fan-out es parte del mecanismo que amplía quién puede aparecer ahí. El mapa completo de elegibilidad, RAG y qué ignorar (AEO/GEO, llms.txt, chunking) lo desarrollamos en cómo aparecer en AI Overviews y AI Mode. Qué son esas citaciones (= links de soporte), cómo se miden y qué no lo son está en citaciones de Google en búsqueda con IA.
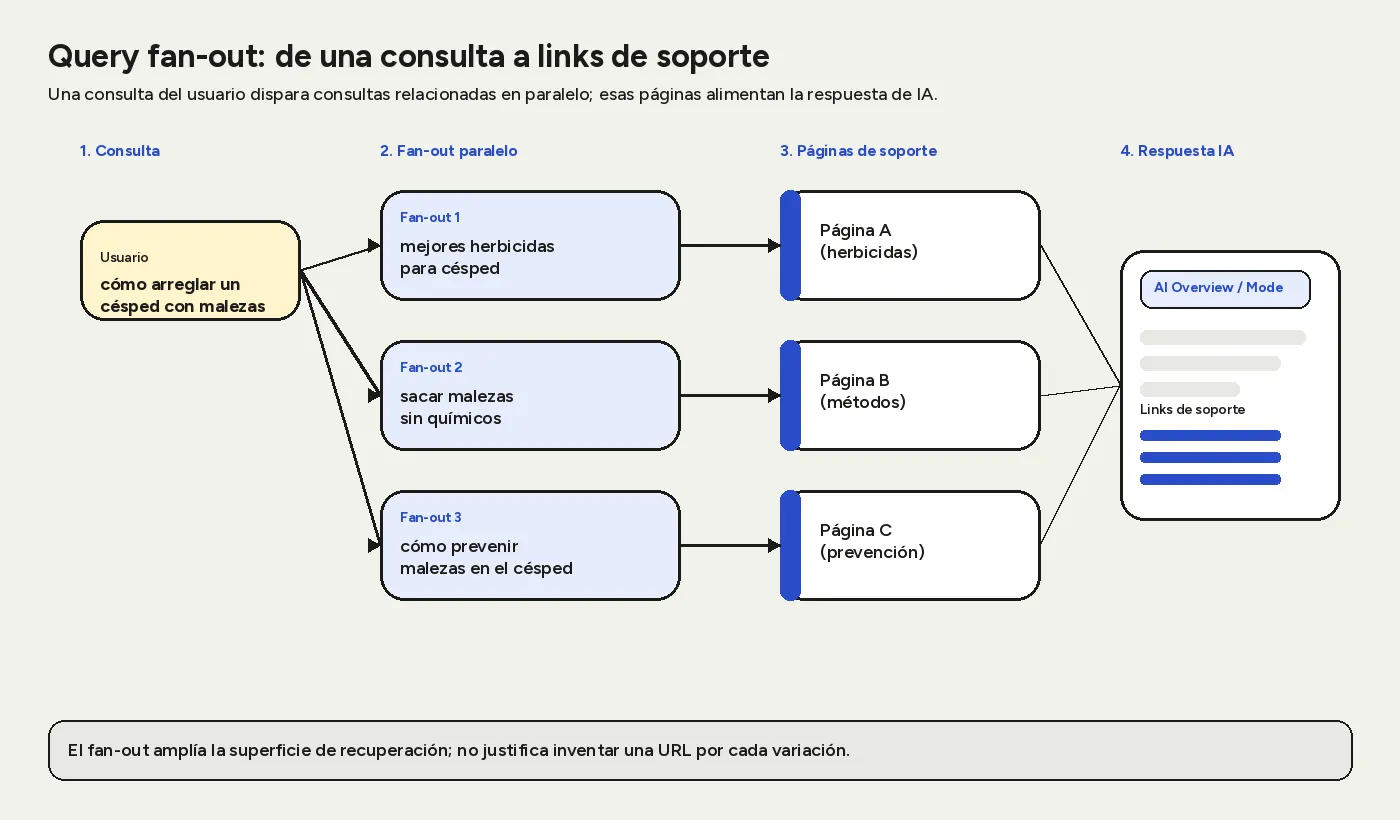
*De una consulta a links de soporte: el fan-out amplía la superficie de recuperación; no justifica inventar una URL por cada variación.*
¿Cómo se relaciona con RAG / grounding?
En la misma guía de optimización, Google describe RAG (retrieval-augmented generation) —también llamado *grounding*— como la técnica para mejorar calidad, precisión y frescura de las respuestas de IA: los sistemas centrales de ranking recuperan páginas relevantes y actualizadas del índice; luego revisan información concreta de esas páginas para generar una respuesta más confiable, con enlaces clicables a las páginas que la sostienen.
El fan-out no reemplaza al RAG: lo alimenta. Amplía la superficie de recuperación (más consultas concurrentes → más candidatos) antes de anclar (*ground*) la respuesta con páginas de soporte. Sin páginas indexables, útiles y recuperables, no hay mucho que “fan-outear” a tu favor.
Por eso el fan-out no es un atajo de “SEO para IA” aparte del SEO que ya conocés. Es otra capa del mismo circuito: rastreo, índice, relevancia, y ahora una generación que cita fuentes.
En términos de equipo, conviene separar dos conversaciones que a menudo se mezclan:
- Recuperación: ¿estamos en el índice, somos crawlables, el contenido importante está en texto, las landings comerciales no están huérfanas?
- Mérito editorial: ¿cuando el sistema recupera candidatos, somos la página que aporta algo que vale citar?
El fan-out empuja la primera (más puertas de entrada) y exige la segunda (porque esas puertas llevan a páginas reales). Si solo optimizás “para ser mencionado en el Overview” sin mejorar la página, estás empujando el carrito por el mango equivocado.
¿Por qué puede mostrar links más diversos?
Porque el sistema no se limita a un único ranking para la consulta exacta. Al emitir varias consultas relacionadas, puede traer páginas que responden matices distintos (tratamiento, prevención, comparación, caso concreto) y mostrarlas como soporte de la misma respuesta.
Google lo dice de frente en la página de AI features: mientras se genera la respuesta, los modelos identifican más páginas de soporte y permiten un set de links más amplio y diverso que en el Search clásico. Eso abre oportunidades para sitios que no necesariamente “ganan” el puesto #1 azul, pero sí cubren bien un subtema útil.
La lectura sana para un equipo de contenido: diversidad de links no significa “publicá veinte variaciones casi idénticas”. Significa que una página profunda, clara y con evidencia puede entrar por caminos que no son la keyword head exacta. Si tu pieza solo recicla lo que ya está en todas partes, el fan-out no te salva: el sistema sigue priorizando contenido que aporte valor real, alineado con contenido útil, confiable y people-first.
Un ejemplo mental (no una métrica inventada): imaginá una guía seria sobre “rediseñar un sitio sin perder SEO”. El fan-out podría explorar migraciones, redirecciones, Core Web Vitals o contenido thin. Si tu guía trata esos matices con criterio —y no como relleno— puede ser recuperada aunque la persona no haya tipeado exactamente tu H1. Si en cambio publicaste cinco posts casi iguales (“redirecciones 301”, “redirects 301”, “cómo hacer 301”), no ganaste diversidad: ganaste canibalización y riesgo de abuso a escala.
¿Qué no hacer? (una URL por cada fan-out → scaled content abuse)
Aquí Google es explícito y vale citarlo sin rodeos. En la guía de optimización para IA, advierte que puede ser tentador crear contenido separado para cada variación de cómo la gente busca —por ejemplo, enfocándote en otras consultas que hicieron o en fan-out queries—, pero hacerlo principalmente para manipular rankings o respuestas de IA viola la política de abuso de contenido a escala (*scaled content abuse*).
También dice que es una estrategia ineficaz a largo plazo: mucha cantidad de páginas no hace al sitio más de calidad ni más relevante. Los sistemas de IA de Google mejoraron su capacidad de entender relevancia aunque no haya match exacto entre la consulta y el contenido primario de la página.
En ARTDEPARTMENT lo traducimos a una regla de redacción y de sitemap:
- No fabriques una URL por cada matiz hipotético del fan-out.
- No clones landings comerciales con sinónimos y H1 distintos “por si el modelo pregunta distinto”.
- Sí cubrí matices reales dentro de piezas profundas, con estructura clara, cuando el lector los necesita.
Scaled content abuse no es solo “usaste IA”: es generar muchas páginas con poco valor, con el objetivo principal de manipular Search. El fan-out no es una licencia para inflar el CMS; es una razón más para no hacerlo.
Señales de alarma en un calendario editorial:
- Plantillas que solo cambian ciudad, sinónimo o “para principiantes / avanzados” sin cambiar la sustancia.
- Publicar en lote variaciones “porque el fan-out podría preguntarlo”.
- Landings comerciales que repiten el mismo párrafo con H1 distintos.
- Autores o bylines vacíos en temas donde el lector espera expertise.
Si alguna de esas es la estrategia, el problema no es “falta de cobertura de fan-out”: es calidad y política de spam.
¿Cómo planear contenido útil frente al fan-out?
La respuesta oficial se parece mucho a lo que ya pedía el Search bueno: contenido no commodity, people-first, con punto de vista y organización legible. La guía insiste en que eso pesa más, a largo plazo, que cualquier checklist de trucos para Overviews. El post de Succeeding in AI search vuelve sobre lo mismo: foco en contenido único y valioso para personas.
Un plan editorial práctico (sin inventar métricas ni URLs fantasma):
- Elegí intenciones reales del negocio, no una lista infinita de long-tails inventados. ¿Qué consultas resuelve tu producto, tu servicio o tu expertise?
- Diseñá una URL fuerte por tema central, con secciones que cubran matices (qué es, cuándo aplica, alternativas, errores comunes, evidencia). El fan-out puede “llegar” a distintas secciones vía relevancia, no vía clones.
- Escribí para quien lee, con encabezados navegables. Google recuerda organizar por párrafos y secciones; no hace falta “chunking” artificial para la IA.
- Agregá lo que solo vos podés agregar: proceso, criterios, datos propios, capturas, límites honestos. Commodity (“7 tips genéricos”) pierde; no commodity gana espacio en recuperación y en confianza.
- Enlazá internamente hacia hubs y landings comerciales reales. Si una página satélite no se alcanza desde el sitio, tampoco ayuda al lector —ni al crawl.
- Actualizá en profundidad cuando el tema cambia, en vez de multiplicar URLs casi iguales.
Para landings comerciales, la pregunta operativa es la misma de siempre: ¿esta URL responde una intención con algo que solo nosotros decimos bien, o es un eco del SERP? Query fan-out no cambia esa pregunta; la vuelve más cara si respondés mal con volumen.
Un ejercicio concreto que usamos en ARTDEPARTMENT: tomá el tema central, listá los 4–6 matices que un cliente o lector pediría en una reunión (no en un keyword tool), y preguntate si caben en una pieza bien estructurada o si alguno merece su propia URL porque es un producto, un caso o una intención distinta. Si el matiz es solo un sinónimo, no merece URL. Si es un viaje completo (por ejemplo, “informe de IA en Search Console” vs “qué es el fan-out”), sí: son piezas hermanas, no clones.
¿Qué se mide (y qué no) en Search Console?
Lo que Google señala para medir visibilidad en features de IA es el informe de rendimiento de IA generativa (Generative AI performance report) en Search Console: impresiones de tus URLs en capacidades como AI Overviews y AI Mode (y el reporte hermano en Discover), con dimensiones útiles (páginas, países, dispositivos, fechas). La ayuda oficial está en el informe de rendimiento de IA generativa.
Lectura honesta de lo que sí y lo que no tenés:
- Sí: tendencia de impresiones en features de IA; qué páginas concentran visibilidad; cortes por país/dispositivo/fecha.
- Sí (complemento): esas apariciones también entran en el Performance general, tipo Web, como documenta Google en AI features.
- No (típico): una lista exportable de las consultas internas de fan-out que el modelo disparó para cada impresión. Ese detalle interno no es lo que el informe te entrega para “mapear fan-outs → URLs a crear”.
Si alguien te vende un dashboard con “las fan-out queries exactas de Google para tu sitio”, pedí la fuente primaria. Ninguna herramienta de terceros tiene acceso a los sistemas internos de ranking o de IA de Google; la propia guía de optimización lo advierte.
Para el día a día, un ritual sobrio alcanza: mirar semanas (no un día ruidoso), cruzar páginas que deberían brillar (guías y landings comerciales) versus thin/archivos, y usar Analytics para clics, tiempo y conversiones. El detalle operativo del panel lo ampliamos en el informe de IA generativa en Search Console.
También vale recordar el horizonte de expectativas: impresiones en features de IA no equivalen automáticamente a clics, y Google ha señalado que los clics desde páginas con AI Overviews pueden ser de mayor calidad (más tiempo en sitio). Eso no justifica inventar KPIs de “share of fan-out”. Justifica mirar valor de visita —consultas, demos, ventas, lecturas profundas— junto con el informe, no en lugar de él.
Planear contenido que sobrevive al fan-out
El fan-out no pide un sitemap hiperfragmentado. Pide páginas que merezcan ser recuperadas cuando el modelo abre el abanico: claras, indexables, con matices reales y sin teatro de “una URL por sinónimo”.
Si tu prioridad es que el blog y las landings comerciales sostengan Search clásico y features de IA sin inventar URLs, el trabajo sigue siendo SEO de Search: diagnóstico, técnico, contenido y medición sobre el sitio real. Cuando necesitás cubrir las búsquedas derivadas de una consulta, ese es el puente operativo —las mismas bases que Google documenta, sin hacks de AEO ni páginas clon para cada fan-out.