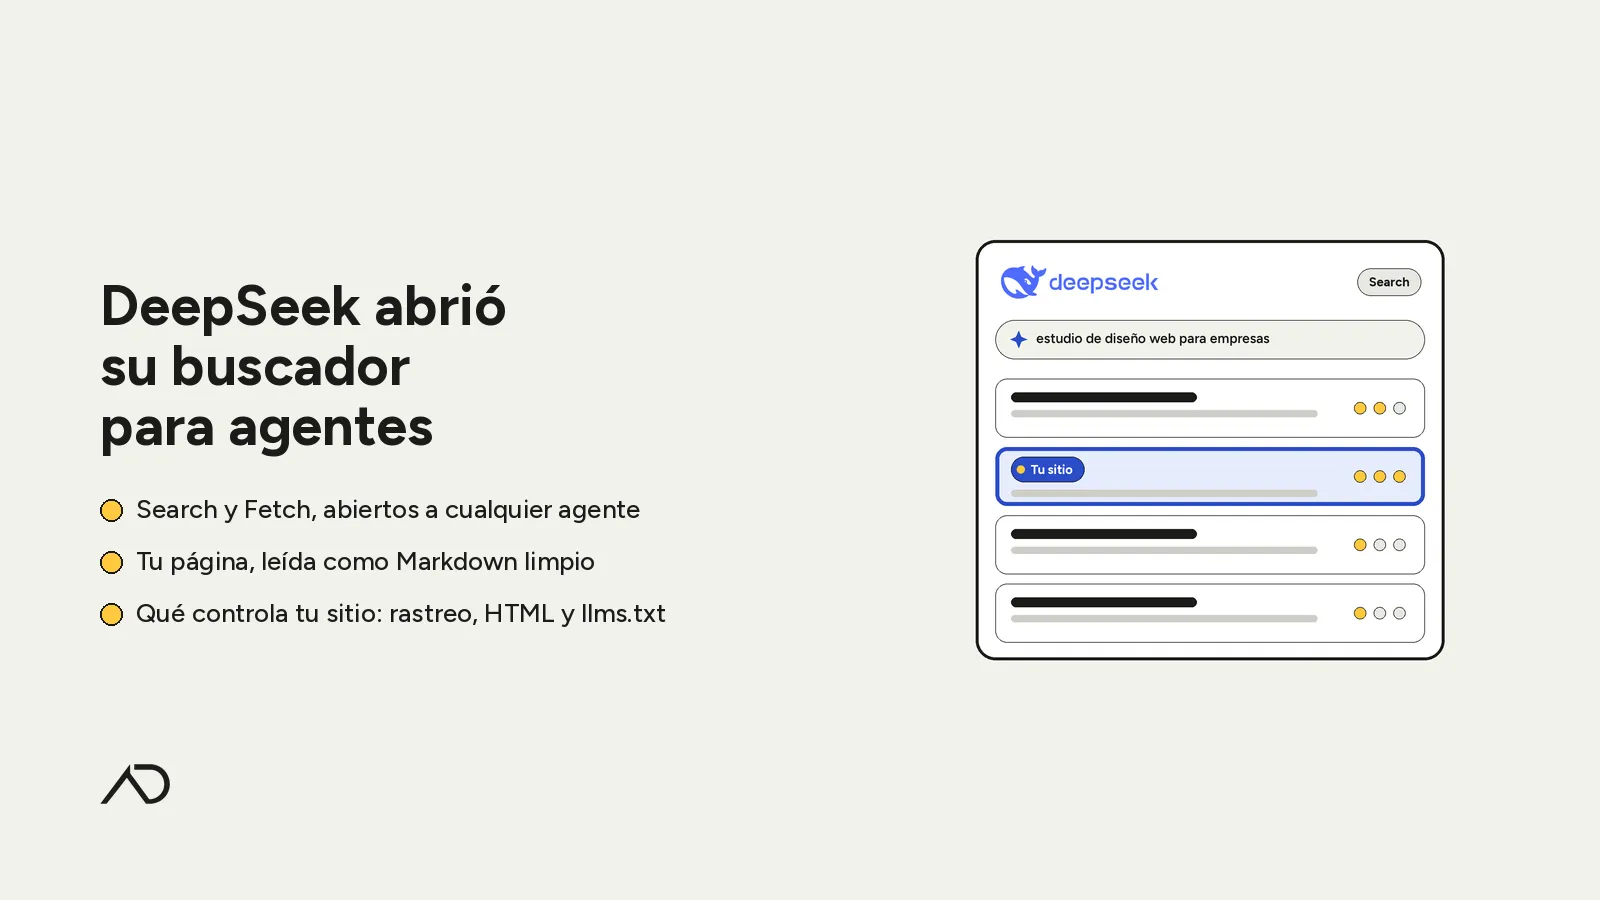
El 17 de octubre de 2026, DeepSeek abrió a cualquier desarrollador dos APIs: la DeepSeek Search API, que busca en su propio índice de la web, y Fetch API, que lee una página y la devuelve en Markdown. Cada una cuesta USD 0,75 cada 1.000 llamadas exitosas. Para tu sitio, eso significa que hay un buscador más, fuera de Google, del que los agentes de IA pueden sacar sus fuentes.
En esta nota vas a ver qué lanzó DeepSeek y qué datos le entrega a un agente sobre tu página. También qué dice y qué calla sobre el rastreo, y qué podés preparar en tu sitio sin depender de promesas que nadie documentó.
Qué lanzó DeepSeek: Search API y Fetch API, a USD 0,75 cada 1.000 llamadas
El anuncio de DeepSeek en X fue directo: las APIs de Search y Fetch quedaron abiertas para todos. La empresa dice que funcionan sobre su buscador propio y que ese buscador atiende cientos de millones de pedidos por día. Ese volumen es lo que declara DeepSeek; no hay una medición independiente que lo confirme.
La guía oficial Search & Fetch da el detalle técnico. Son dos endpoints que se llaman con la misma clave de la API de DeepSeek:
- Search API: recibe una consulta de hasta 128 caracteres y devuelve entre 1 y 50 resultados estructurados.
- Fetch API: recibe una URL y devuelve el título y el contenido de esa página convertido a Markdown.
- Precio: USD 0,75 cada 1.000 pedidos exitosos, por endpoint. Solo se cobra el pedido que devuelve un resultado; los errores, las búsquedas vacías y los tiempos agotados no se cobran.
- Límites: 5 pedidos por segundo por cuenta en cada API. Fetch suma además un límite por dominio.
Hay un detalle de calendario. Cuando las llamadas pasan por las herramientas del lado del servidor de DeepSeek Harness, Claude Code o Codex, hoy son gratis para quienes usan la API de DeepSeek. El cobro empieza el 31 de octubre de 2026 a las 13:00, hora de Argentina.
El mismo día, DeepSeek presentó un modelo nuevo de código abierto, DeepSeek-V4.1-Flash-1017. Es otro tema. Lo que importa acá es el buscador, porque cambia quién puede encontrarte.
Los agentes ya no buscan solo en Google o Bing
Un agente que necesita buscar en la web tiene que apoyarse en el índice de alguien. Con esta apertura, cualquier desarrollador puede conectar su agente a un índice que no es de Google ni de Bing, pagando por llamada. Los buscadores de inteligencia artificial dejan de ser un puñado de productos cerrados y pasan a ser también infraestructura que se compra por API.
Para quien tiene un sitio, el efecto es concreto. Una persona puede preguntarle algo a un asistente armado por una empresa que nunca escuchaste nombrar, y la respuesta puede salir de lo que encontró la Search API de DeepSeek. Ese asistente no pasa por la página de resultados de Google, así que tu posición ahí no garantiza que aparezcas.
No hace falta empezar de cero. Google sigue mostrando sus propias respuestas con IA en AI Overviews (visión general creada por IA) y AI Mode (modo IA de Google). ChatGPT o Perplexity usan sus propias fuentes. Como explicamos en GEO vs SEO: cómo lograr que Google y ChatGPT citen tu sitio, cada plataforma elige sus fuentes con su propio sistema. DeepSeek suma uno más a esa lista, con una diferencia: lo vende a terceros.
Entonces la pregunta útil es cómo se ve tu página cuando un agente la pide por esta vía.
Cómo te ve un agente: resultados con puntaje de autoridad y tu página convertida en Markdown
Cuando un agente usa la Search API, no recibe una lista de enlaces azules. Recibe, por cada resultado, un paquete de datos que el programa lee antes de decidir qué abrir:
- title y url: el título y la dirección de la página.
- snippet: un resumen corto relacionado con la consulta, de 100 a 200 caracteres, pensado para mostrarse en pantalla.
- summary: un resumen largo, de 600 a 800 caracteres, que según la documentación está pensado para que lo lea un modelo.
- date: la fecha de publicación, o nada si el sistema no la conoce.
- rerank_score: un puntaje de 0 a 3 que combina relevancia, autoridad y actualidad. Desde 1,5 se considera un resultado de alta calidad.
- authority: un nivel de autoridad de la página, de 0 a 4. Desde 3 se considera una fuente muy autoritativa.
Dos cosas saltan a la vista. La primera es que el agente puede quedarse con el summary y no abrir nunca tu página. La segunda es que DeepSeek pone números a la autoridad y a la calidad, pero no explica cómo los calcula. No hay una guía para subir esos puntajes, y conviene desconfiar de quien la ofrezca.
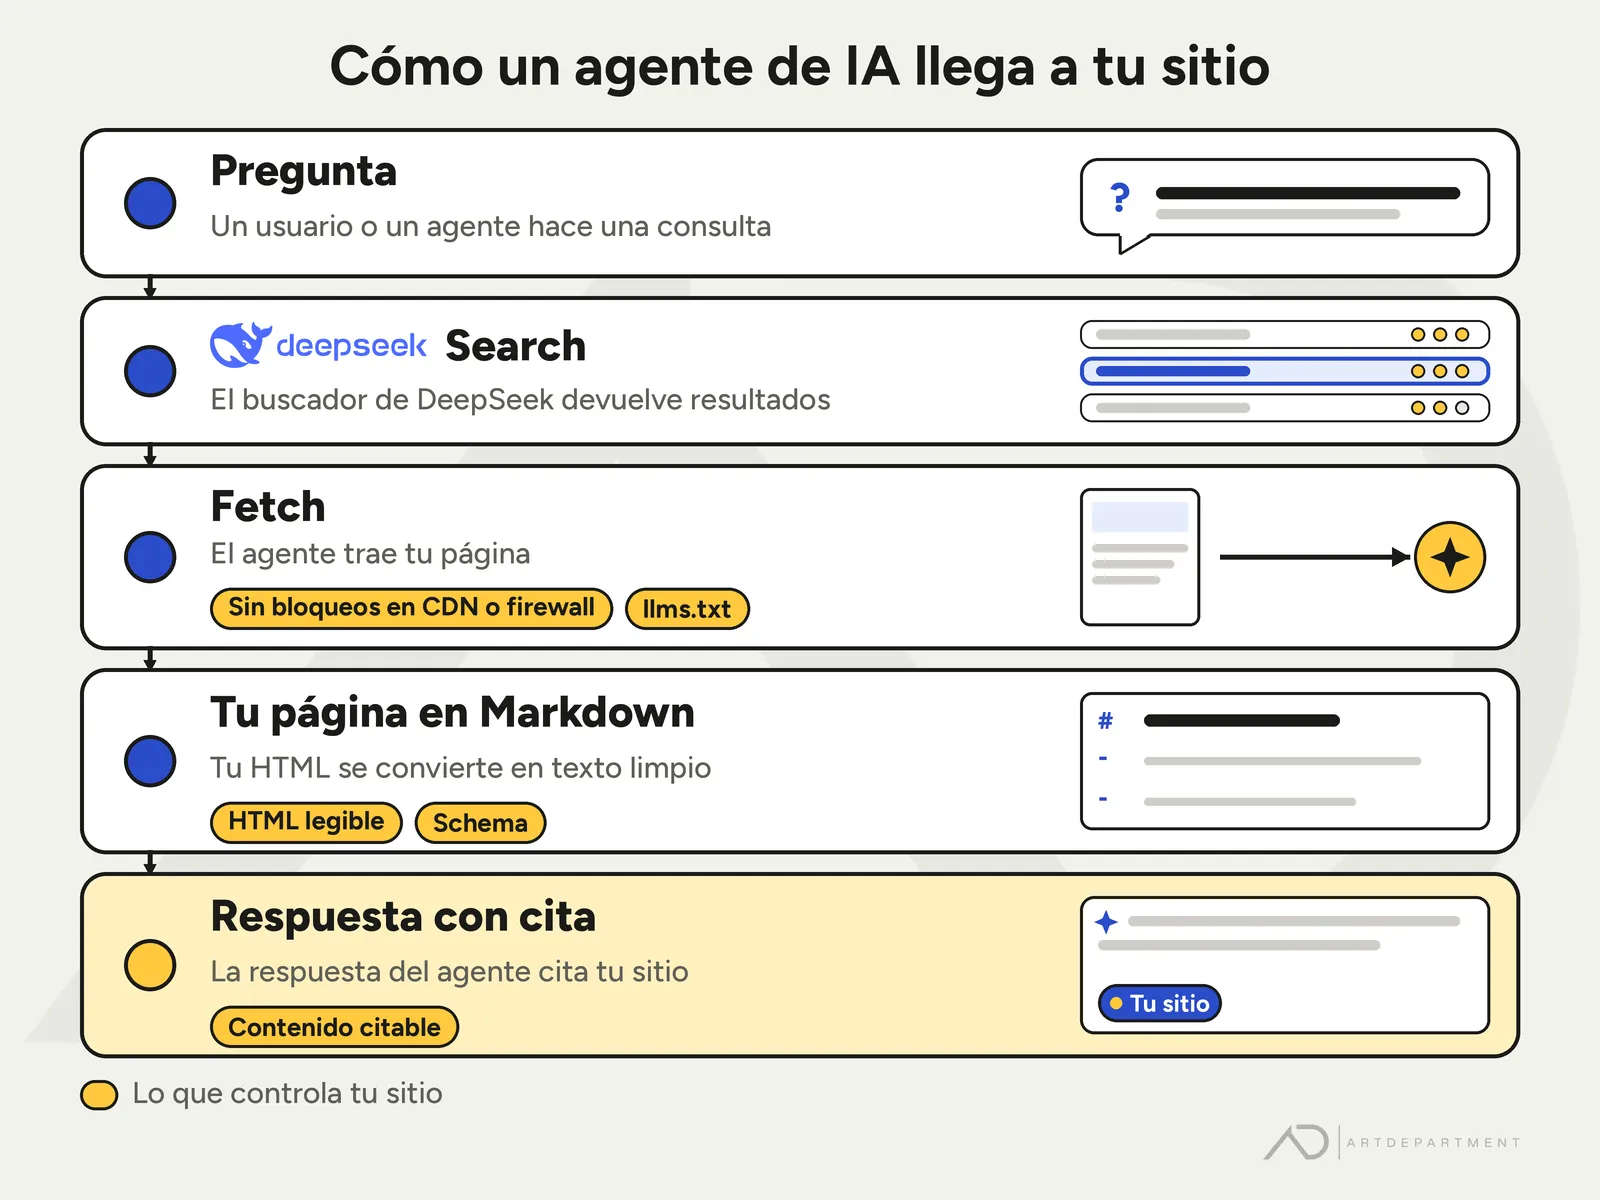
Si el agente decide leer la página completa, usa la Fetch API. La referencia de Fetch dice que devuelve el título y el contenido en Markdown. Es decir, tu diseño desaparece: quedan los títulos, los párrafos, las listas y los enlaces. Si el texto importante está bien marcado en el HTML, sobrevive a esa conversión. Si depende de scripts que se ejecutan en el navegador o está dentro de una imagen, hay riesgo de que no llegue.
Por eso pesa tanto tener HTML listo desde el servidor: la página llega completa en la primera respuesta, sin esperar a que el navegador arme el contenido. Ahora bien, para que un agente pueda leerte, primero tiene que poder entrar.
Rastreo y robots.txt: lo que DeepSeek documenta y lo que no
Revisamos la documentación oficial de Search y Fetch y DeepSeek no publica un user-agent para su rastreador ni dice cómo trata el archivo robots.txt. La única referencia al tema es una frase: la lectura de páginas está sujeta a la disponibilidad y a las políticas de acceso del sitio de destino.
En la tabla de errores aparecen dos pistas más. Fetch devuelve un error 404 cuando no puede obtener contenido útil, por ejemplo porque la URL está bloqueada por la política del sitio. Y devuelve un 403 cuando su propia política de seguridad rechaza el pedido. Qué cuenta como "política del sitio" no está explicado.
Algunas listas de bots armadas por terceros incluyen un nombre como DeepSeekBot, pero DeepSeek no lo confirma en su documentación. Hasta que lo publique, cualquier regla escrita para ese nombre es una apuesta.
Conviene recordar qué es robots.txt. El estándar, el RFC 9309: Robots Exclusion Protocol, define reglas que se les pide a los rastreadores que respeten, y aclara que esas reglas no son una forma de autorización de acceso. Google lo dice con otras palabras en su Introducción a robots.txt: el archivo sirve sobre todo para no sobrecargar el sitio, y no es un mecanismo para dejar una página fuera de Google.
Con esa base, hay tres revisiones que sí podés hacer hoy:
- Tu robots.txt: que no tenga bloqueos amplios que nadie recuerda haber escrito, como un Disallow general para cualquier agente.
- Tu CDN o tu firewall: muchos bloquean bots desconocidos por defecto. Si querés que los agentes te lean, decidilo vos y no lo dejes en manos de una regla automática.
- Tus logs del servidor: mirá qué pedidos llegan, de dónde y con qué user-agent, para tener una línea de base antes de decidir.
Que el agente pueda entrar es la mitad del trabajo. La otra mitad es que encuentre algo legible.
Un sitio legible por máquinas: HTML semántico, contenido en texto, velocidad y fechas visibles
Un sitio legible por máquinas es el que entrega su contenido como texto ordenado en el HTML, rápido y con contexto claro. No es un requisito que haya publicado DeepSeek. Es lo que hace falta para que cualquier conversión a Markdown, la de DeepSeek o la de otro sistema, conserve lo importante.
- HTML semántico: un solo H1, H2 y H3 que reflejen la estructura real, listas como listas y tablas como tablas. Al pasar a Markdown, esa jerarquía es lo que queda.
- Contenido en texto: precios, requisitos, horarios y datos de contacto escritos en la página, no solo dentro de una imagen o de un PDF.
- Velocidad: la documentación de Fetch incluye un error para cuando una consulta a otro servidor tarda demasiado. Una página que responde rápido le da menos motivos al agente para seguir de largo. Para medir esa velocidad con visitas reales y saber qué arreglar primero, tenés las métricas de velocidad que mide Google y cómo priorizarlas.
- Fechas visibles: la Search API devuelve la fecha de publicación y acepta filtros por fecha. Mostrar cuándo publicaste y cuándo actualizaste ayuda a que esa fecha se pueda leer.
Ejemplo hipotético, inventado solo para ilustrar: un estudio contable publica sus honorarios orientativos como imagen. Un agente que lee la página en Markdown se queda con el título y un espacio vacío. Si esos mismos datos están en una tabla de HTML, llegan completos. Si el problema está en la plantilla y se repite en todo el sitio, quizá toque rehacerlo, y para eso conviene seguir una checklist para rediseñar sin perder el posicionamiento.
Con el sitio legible, aparecen dos archivos que suelen venderse como atajo: llms.txt y schema.
llms.txt y schema: qué suman y qué no prometen
El llms.txt es un archivo de texto que resume tu sitio para modelos de lenguaje. Nosotros lo recomendamos y en ARTDEPARTMENT tenemos uno, porque ordena qué querés que se lea primero. Pero hay que ser claros con lo que no hace: DeepSeek no menciona llms.txt en su documentación de Search y Fetch, así que no hay evidencia de que lo use.
Google tampoco lo pide. En AI features and your website explica que no hace falta crear archivos nuevos legibles por máquinas ni archivos de texto para IA. Tampoco marcado especial para aparecer en sus funciones de IA. John Mueller aclaró que llms.txt no es para la Búsqueda: Google no lo usa para posicionar. Pero Google sí lo publica y lo usa en otros frentes. Tiene sus propios archivos en sitios de documentación como developer.chrome.com/docs/llms.txt y ai.google.dev/gemini-api/docs/llms.txt, y en diciembre de 2025 Lidia Infante detectó uno en la documentación de Search Central, que después se retiró. Además, desde mayo de 2026 Lighthouse revisa si tu sitio tiene uno en sus auditorías experimentales para agentes. Por eso lo seguimos recomendando: no te va a subir en Google, pero ayuda a que los agentes entiendan tu sitio. Si querés el detalle, lo repasamos en lo que Google documenta para AI Overviews y AI Mode.
Con el schema pasa algo parecido. Los datos estructurados no son un factor directo de ranking, pero anclan quién sos: tu empresa, tus autores, tus productos y tus fechas. Google lo explica en su Introducción al lenguaje de marcado de datos estructurados en la Búsqueda de Google: usa ese marcado para comprender el contenido de la página. Que otros sistemas también lo aprovechen es razonable, aunque ninguno lo garantiza.
Los dos archivos suman orden, pero ninguno reemplaza a lo que de verdad se cita: el contenido.
Contenido citable para agentes que hacen varias búsquedas
Un agente no hace una sola búsqueda. La Search API está pensada para que lance varias, cada una afinada con operadores: site: para limitarse a un dominio, lang: para un idioma, after: y before: para un rango de fechas, y comillas para una frase exacta. Además, acepta un campo llamado ori_question con la pregunta original del usuario, que DeepSeek usa para entender mejor la consulta.
Es el mismo patrón que Google llama query fan-out: una pregunta se divide en varias consultas más chicas. Cada una es una oportunidad de que tu página aparezca, siempre que responda esa parte en concreto. Así se ve en la práctica:
- Una respuesta directa por sección: la primera oración de cada H2 contesta la pregunta del título. Es lo que mejor sobrevive al summary de 600 a 800 caracteres.
- Párrafos que se entienden solos: que nombren el tema en lugar de depender de "esto" o "lo anterior".
- Datos con su fuente: cifras, requisitos y fechas con el enlace al documento original.
- Fechas de actualización reales: si un agente filtra con after:, una página vieja sin fecha visible puede quedar afuera.
Este trabajo de ordenar temas, URLs y respuestas es SEO bien hecho, con una capa más para los agentes. Si querés armar una estrategia de posicionamiento SEO que también piense en IA, ahí está el método completo. Y una vez que el contenido está listo, falta saber si alguien lo está leyendo.
Cómo saber si los agentes de IA te leen: logs y RankVice
Hoy no hay una forma oficial de saber si la Search API de DeepSeek te muestra o si la Fetch API te leyó. DeepSeek no ofrece un panel para sitios y Search Console solo mide lo que pasa en Google. Lo que sí podés hacer es combinar señales:
- Logs del servidor: registrá los pedidos de agentes y bots, con su user-agent y su IP. Como DeepSeek no publica el suyo, no vas a poder atribuirle cada visita con certeza, pero sí vas a ver cambios en el tráfico automatizado.
- Search Console para Google: sigue siendo la fuente oficial para AI Overviews y AI Mode, y sirve como comparación.
- Monitoreo de citas: hay herramientas como RankVice, que se presenta como un servicio que sigue cómo te mencionan los asistentes de IA. Usalas para ordenar el seguimiento, sabiendo que ninguna tiene acceso a los sistemas internos de esas plataformas.
- Un set fijo de preguntas: las mismas consultas cada mes, en los asistentes que usan tus clientes, anotando quién aparece citado.
Con esa rutina ya tenés una línea de base. Quedan algunas dudas que aparecen siempre.
Preguntas frecuentes
¿Puedo bloquear a DeepSeek?
En parte. Podés bloquear pedidos desde tu servidor, tu CDN o tu firewall, y la documentación de Fetch dice que una URL bloqueada por la política del sitio devuelve error. Lo que no podés hacer con certeza es escribir una regla de robots.txt solo para DeepSeek, porque no publica el nombre de su rastreador ni dice si respeta ese archivo.
¿Necesito un llms.txt?
No es obligatorio. Google dice que no hace falta para sus funciones de IA y DeepSeek no lo menciona. Lo recomendamos porque ordena tu sitio para cualquier modelo, pero no reemplaza a un HTML claro y a un contenido citable.
¿Esto reemplaza al SEO?
No. Rastreo, HTML limpio, contenido útil y autoridad son la base del SEO y también lo que necesita un agente para leerte. Lo que cambia es que tu visibilidad ya no depende de un solo índice.
¿Cuánto cuesta para un desarrollador?
USD 0,75 cada 1.000 llamadas exitosas en cada endpoint, según la guía oficial. Ejemplo hipotético: un agente que hace 1.000 búsquedas y lee 1.000 páginas paga USD 1,50. Las llamadas desde DeepSeek Harness, Claude Code y Codex son gratis hasta el 31 de octubre de 2026 a las 13:00, hora de Argentina.
DeepSeek abrió un buscador para que cualquier agente encuentre y lea páginas, pero no explicó cómo entra a tu sitio ni cómo te puntúa. Lo que está en tus manos es que te puedan leer: acceso decidido, HTML limpio, datos en texto, fechas visibles y respuestas claras. Si querés que veamos juntos cómo leen hoy tu sitio los agentes de IA, contanos qué páginas te importan y qué querés que encuentren y lo revisamos con vos.